Das Wichtigste auf einen Blick
- Prüfe Modellanfragen zentral, statt die Regeln in jedem mobilen Client einzeln umzusetzen.
- Vor der Generierung lassen sich Anfragen blockieren, anpassen und mit Token-Limits versehen.
- Nach der Generierung lassen sich Antworten schwärzen und relevante Entscheidungen protokollieren.
- Mandantenrichtlinien sollten konfigurierbar sein – nicht je Kunde eine eigene Tutor-Implementierung erfordern.
- Tutor-Telemetrie wird wertvoll, wenn sie mit Lernergebnissen und Richtlinienentscheidungen verknüpft ist.
Eine zentrale Prüfung für Tutor-Anfragen
Der KI-Tutor wird Teil der Laufzeitumgebung für mobiles Lernen. Er beantwortet Fragen im Onboarding, erklärt neue Bankprodukte, übt schwierige Gespräche und unterstützt Mitarbeitende direkt im Arbeitsalltag. Damit ist jede Interaktion mit dem Tutor eine produktive Anfrage mit Auswirkungen auf Kosten, Datenschutz, Verhaltensvorgaben und Nachweise. Die Governance für KI-Tutoren darf nicht bei einer losen Sammlung aus Prompts, Prüfungen im Client und manuellen Reviews stehen bleiben.
Am 10. September 2026 kündigten die Release Notes von Firebase eigene serverseitige Skripte für Firebase AI Logic an, die vor und nach jeder über den Dienst an Gemini gesendeten `generateContent`-Anfrage laufen. Google nennt Prompt-Moderation, Token-Limits, Protokollierung der Generierung, Analysen und das Schwärzen von Antworten als vorgesehene Einsatzbereiche. Für ein KI-Lernprodukt mit Flutter schafft das eine sinnvolle Grenze zwischen der wiederverwendbaren Tutor-Oberfläche und den Kontrollen, die jeder Kunde benötigt.
Das ist eine Architekturoption, keine vollständige Compliance-Antwort. Firebase kennzeichnet die Trigger-Funktion als Preview, ohne SLA oder Abkündigungsrichtlinie. Banken sollten daher Reifegrad, Standortkonzept, Verhalten bei Ausfällen, Datenverarbeitung, Zugriffskontrollen und Lieferantenpflichten prüfen, bevor sie die Funktion als regulierte Kontrolle im Produktivbetrieb einsetzen.
Unterschiedliche Kundenregeln machen Kontrollen im Client aufwendig
Kontrollen direkt in der App liegen nah am Lernerlebnis. Die Anforderungen von White-Label-Kunden unterscheiden sich jedoch: Eine Bank verlangt strikte Regeln für Kundendaten und ausführliche Audit-Ereignisse. Eine andere braucht kurze Antworten, niedrige Token-Limits und möglichst wenig Speicherung. Eine dritte beschränkt den Zugriff bestimmter Mitarbeitergruppen auf freigegebenes internes Wissen.
Sind diese Regeln in der App hinterlegt, müssen Teams Varianten für iOS und Android pflegen. Zwischen Versionen können Unterschiede entstehen, und dringende Regeländerungen warten auf den Store-Rollout. Eine Kontrolle, die in allen unterstützten Versionen gelten soll, braucht deshalb eine verlässliche Instanz außerhalb des einzelnen Clients.
Die App kann weiterhin eine schnelle, verständliche Tutor-Oberfläche bereitstellen. Der Server prüft zentral, ob die Anfrage zulässig ist, welche Vorgaben gelten, welche Antwort zurückgegeben werden darf und welche Nachweise nötig sind.
Vor dem Modellaufruf Regeln und Grenzen anwenden
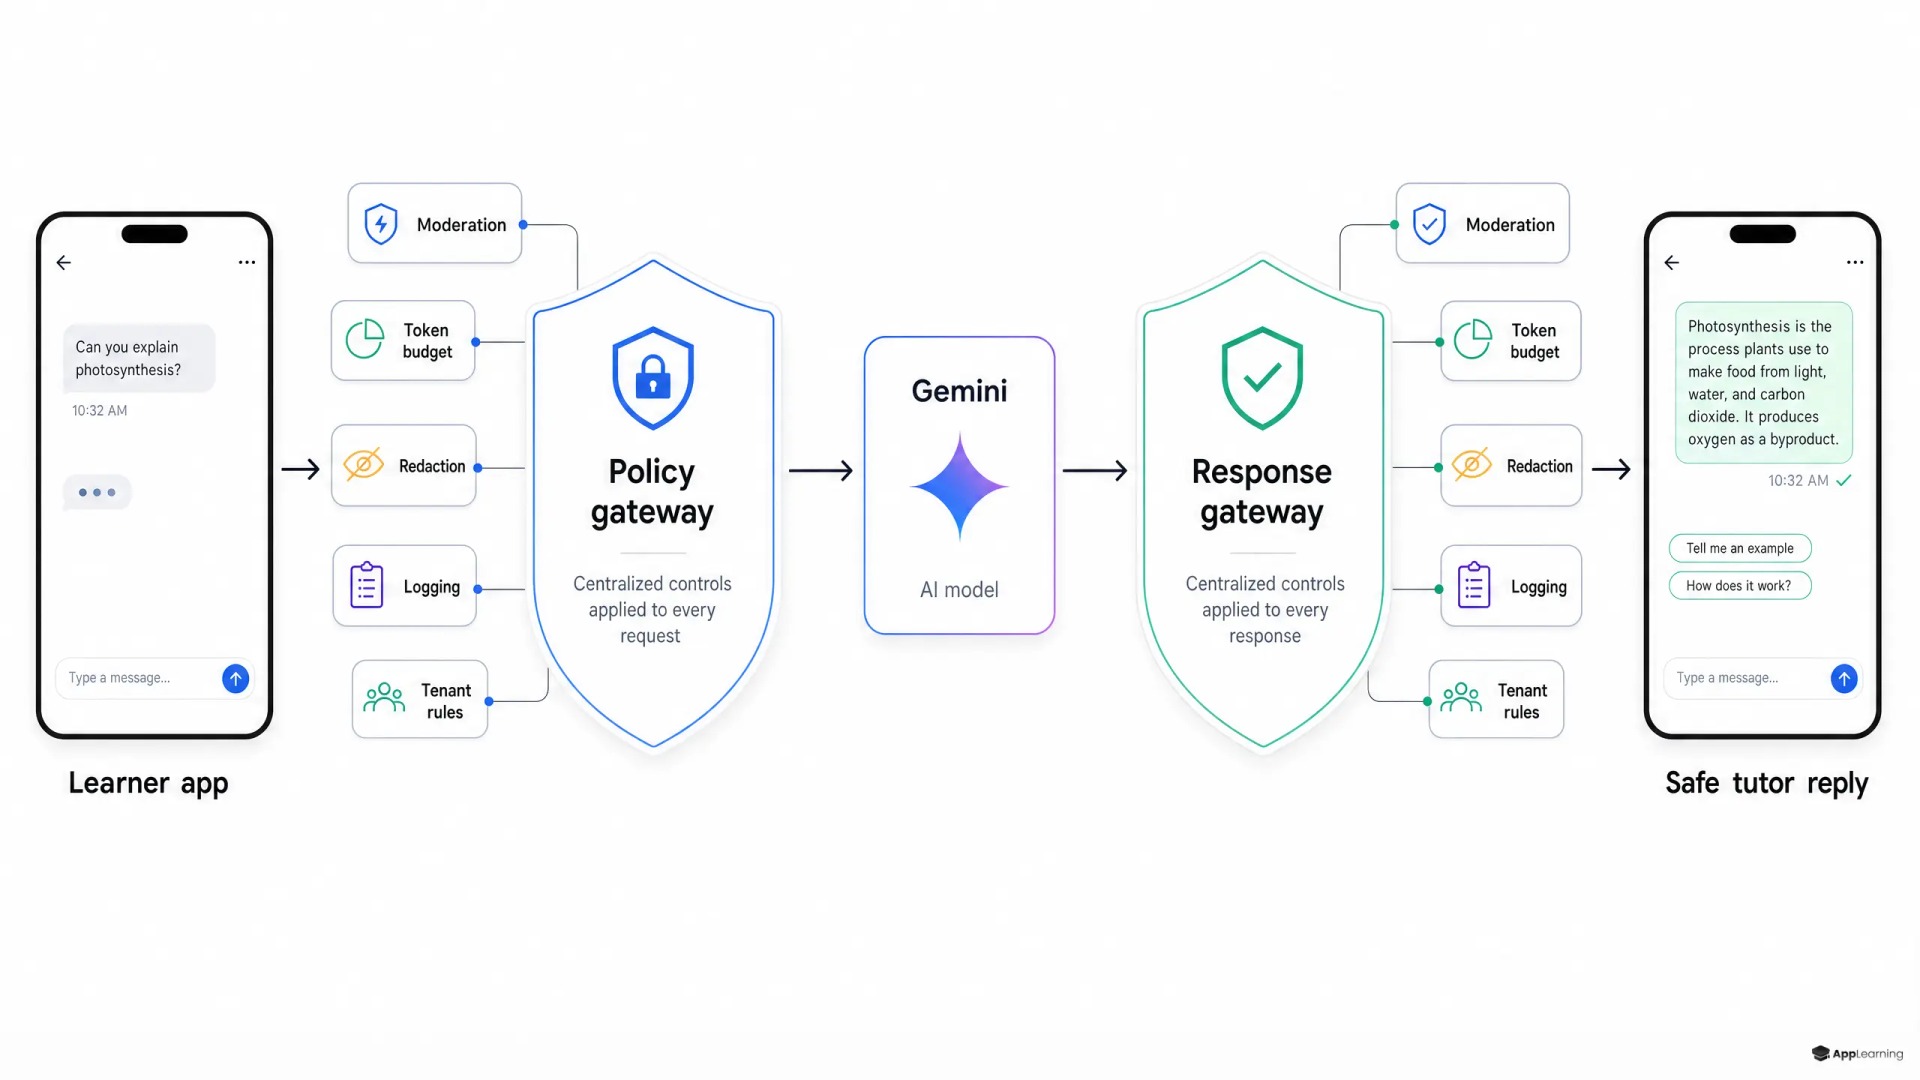
Eine Firebase AI Logic-Funktion `beforeGenerateContent` läuft, bevor die Anfrage das Modell erreicht. Sie kann die Anfrage prüfen, in veränderter Form zurückgeben oder ablehnen. Damit ist sie ein praktischer Ansatzpunkt für serverseitige Leitplanken für KI.
- Mandant, Lernendenrolle, Akademie, Kurs und Richtlinienversion anhand der vertrauenswürdigen Identität und des Anfragekontexts ermitteln.
- Prompts ablehnen, die gegen die vom Mandanten festgelegten Themen, Anwendungsfälle oder Inhaltsgrenzen verstoßen.
- Ausgabe-Tokens begrenzen und über einen gemeinsamen Quota-Service Nutzungslimits pro Nutzer oder Mandant durchsetzen.
- Freigegebene Systemanweisungen anwenden, die den Tutor bei der vorgesehenen Lernaufgabe halten.
- Anfragen an ein freigegebenes Modell und eine passende Konfiguration für das jeweilige Mandantenprofil leiten.
Ein Token-Limit begrenzt die Länge einer einzelnen Antwort. Für die gesamten Kosten reicht das allein nicht aus: Gemeinsame Quoten, Ratenlimits und die Erkennung auffälliger Nutzung müssen mehrere Modellaufrufe berücksichtigen. Diese unterschiedlichen Aufgaben sollten in der Richtlinienprüfung klar getrennt bleiben.
Nach dem Modellaufruf Antwort und Protokoll prüfen
Eine Funktion nach der Anfrage kann die Modellantwort prüfen, ändern, blockieren oder beobachten, bevor sie an die lernende Person zurückgeht. Hier gehören das Schwärzen von Antworten und die strukturierte Erfassung von Ereignissen hin. Die lernende Person erhält die Antwort weiterhin in derselben Tutor-Oberfläche, während die Plattform akademieübergreifend eine einheitliche Ausgaberichtlinie anwenden kann.
- Inhalte schwärzen, die gegen die vom Mandanten festgelegte Richtlinie verstoßen, bevor sie das Gerät erreichen.
- Unsichere oder nicht belegte Ausgaben durch eine kurze, kontrollierte Alternative und einen Verweis auf freigegebene Lernmaterialien ersetzen.
- Modell, Token-Anzahl, Richtlinienversion, Entscheidungsresultat, Kurskontext und Schwärzungsstatus erfassen.
- Nur die unbedingt erforderlichen Ereignisdaten speichern und operative Telemetrie von unbearbeiteten Gesprächsinhalten trennen.
- Muster mit hohem Risiko in einen Review-Prozess mit klaren Zuständigkeiten und Aufbewahrungsregeln überführen.
Ein Protokoll wird erst dann zum brauchbaren Audit-Nachweis, wenn die relevanten Entscheidungen erkennbar sind: Welche Richtlinie galt? Welche Regel griff? Wurde die Antwort geändert? Welcher Lernkontext lag vor? Alle Prompts und Antworten ungefiltert zu speichern kann dagegen zusätzliche sensible Daten sammeln, ohne die Kontrolle zu verbessern.
Mandantenrichtlinien werden zur Produktkonfiguration
Lege die Richtlinien als konfigurierbare Daten ab, statt für jede Bank eine eigene Tutor-Codebasis zu pflegen. Anhand des authentifizierten Mandantenkontexts wird das passende Profil gewählt. Es enthält etwa erlaubte Lernbereiche, Moderationsschwellen, Modelleinstellungen, Token-Budgets, Aufbewahrungskategorien, Schwärzungsregeln, Eskalationswege und die Richtlinienversion.
So entsteht eine wiederverwendbare Tutor-Oberfläche von App-Learning, ohne allen dieselbe Risikoposition aufzuzwingen. Eine Akademie mit hohen Kontrollanforderungen kann offene Fragen außerhalb freigegebener Curricula blockieren und Entscheidungsereignisse zur Prüfung erfassen. Eine interne Innovationsakademie mit geringerem Risiko kann breitere Erkundung erlauben und gleichzeitig Ausgaben strenger begrenzen. Beide Gruppen nutzen dasselbe mobile Interaktionsmuster; die Richtlinienebene verändert die Bedingungen dahinter.
Eine Umsetzungsbeschränkung sollte eingeplant werden. Firebase AI Logic unterstützt pro Projekt höchstens eine Funktion vor und eine nach der Anfrage. In einem Mandanten-Setup spricht das für einen Richtlinien-Dispatcher innerhalb jeder Funktion. Er lädt das passende Mandantenprofil und wendet Regeln in einer vorhersehbaren Reihenfolge an, statt für jeden Kunden einen eigenen Trigger anzulegen.
Good to know
Welche Tutor-Anfragen durchlaufen die Richtlinien-Hooks von Firebase AI Logic?
Die Hooks gelten für `generateContent`-Anfragen über Firebase AI Logic. Firebase dokumentiert, dass Streaming-Anfragen und Anfragen an die Gemini Live API diese Funktionen umgehen; für diese Interaktionsarten braucht es daher ein eigenes Kontrollkonzept.
Kann diese Richtlinienebene die KI-Governance-Anforderungen einer Bank allein erfüllen?
Nein. Eine Richtlinienebene ist nur eine technische Kontrolle innerhalb eines umfassenderen Betriebsmodells mit Risikobewertung, Identitäts- und Zugriffsmanagement, Datenschutz, Modellfreigabe, menschlicher Aufsicht, Tests, Incident-Management und Lieferanten-Governance. Die Firebase-Funktion befindet sich derzeit in der Preview; das sollte bei jeder Bewertung der Eignung für den Produktivbetrieb berücksichtigt werden.
Lassen sich Richtlinien ändern, ohne die mobile App zu aktualisieren?
Ja, bei den serverseitigen Kontrollen, die diese Funktionen abdecken. Firebase erklärt, dass die Skripte ohne Änderungen am Client-Code laufen, und aktualisierte Funktionen nach der Bereitstellung wirksam werden. Änderungen an der Tutor-Oberfläche, dem Anfragetyp des Clients oder dem Lernablauf können dennoch ein App-Release erfordern.
Tutor-Telemetrie muss mit Kompetenznachweisen verknüpft werden
Modelltelemetrie allein misst Systemaktivität, nicht die Kompetenz der Belegschaft. Ein gutes Konzept für Lernanalysen verknüpft Tutor-Ereignisse mit Kursfortschritt, Szenarioversuchen, Bewertungsergebnissen, Vertrauenssignalen, Beobachtungen durch Führungskräfte und rollenbasierten Kompetenzzielen. So wird sichtbar, ob Mitarbeitende den Tutor nutzen, wo sie nicht weiterkommen und ob die Unterstützung zu einer besseren Anwendung des Wissens führt.
Gerade bei KI, Cybersicherheit, Automatisierung, digitalen Vermögenswerten und neuen Bankprozessen brauchen die beteiligten Teams unterschiedliche Einblicke. Innovationsverantwortliche interessieren sich für Nutzung und Vorbereitung, Compliance für Richtlinienentscheidungen und Ausnahmen, Lernteams für Inhaltslücken. Ein gemeinsames Ereignismodell kann diese Fragen beantworten, ohne den Tutor zum Instrument der Mitarbeiterüberwachung zu machen.
Gestalte KI-Tutoren mit klaren, zentral steuerbaren Regeln für jede Akademie.
Gespräch vereinbarenDer regulierte Tutor wird zum wiederverwendbaren System
Eine praktikable Referenzarchitektur ist einfach: Die Flutter-App sendet eine Tutor-Anfrage über Firebase AI Logic; eine Richtlinienfunktion vor der Anfrage ermittelt den Mandantenkontext und wendet Kontrollen an; das Modell generiert die Antwort; eine Funktion nach der Anfrage schwärzt, blockiert oder erfasst das Ergebnis; und eine separate Analyse-Pipeline verknüpft strukturierte Tutor-Ereignisse mit Lernergebnissen. Für sensible Inhalte sollten klare Regeln zur Datenminimierung und Aufbewahrung gelten, nicht die Standardprotokollierung.
Diese Trennung erleichtert die Steuerung: Produktteams behalten eine schnelle Oberfläche, Kunden erhalten passende Kontrollen und Plattformteams können zentrale Regeln ohne mobiles Release aktualisieren. Aus einer einzelnen Tutor-Funktion wird damit ein Lernsystem, dessen Einsatz sich gezielt regeln lässt.