Die wichtigsten Erkenntnisse
- Erfolg bei Aufgaben mit Unterstützung ist kein Beleg für eigenständige Kompetenz.
- Jeder Pilot mit KI-Tutoren braucht einen Abschlusstest ohne Unterstützung.
- Spätere Wissenschecks zeigen, was nach der unmittelbaren Unterstützung im Gedächtnis bleibt.
- Transferaufgaben zeigen, ob Lernende Wissen bei der Arbeit anwenden können.
- Vergleiche den Lernzuwachs mit Kosten, Latenz, Engagement und Nutzung der Unterstützung.
Ein KI-Tutor kann überzeugende Gespräche führen, gute Bewertungen erhalten und Aufgaben beschleunigen, ohne viel zu vermitteln. Lernende sind vielleicht nur seinen Hinweisen gefolgt, haben eine generierte Antwort übernommen oder sich bei jedem Schritt helfen lassen. Zufriedenheit und Nutzung liefern nützliche Hinweise für den Betrieb. Einen Lernerfolg belegen sie für sich genommen nicht.
Für Verantwortliche in HR und L&D bei regulierten Finanz- und Kryptounternehmen ist dieser Unterschied praktisch relevant. Lernende müssen einen Richtlinienverstoß auch erkennen, eine Eskalationsentscheidung begründen oder eine Kontrollmaßnahme anwenden können, wenn der Assistent nicht verfügbar ist. Ein Benchmark für KI-Tutoren sollte deshalb die eigenständige Leistung nach Ende der Unterstützung messen – nicht nur die Leistung im Chat.
Das Gespräch unterstützt das Lernen; es belegt noch keinen Lernerfolg
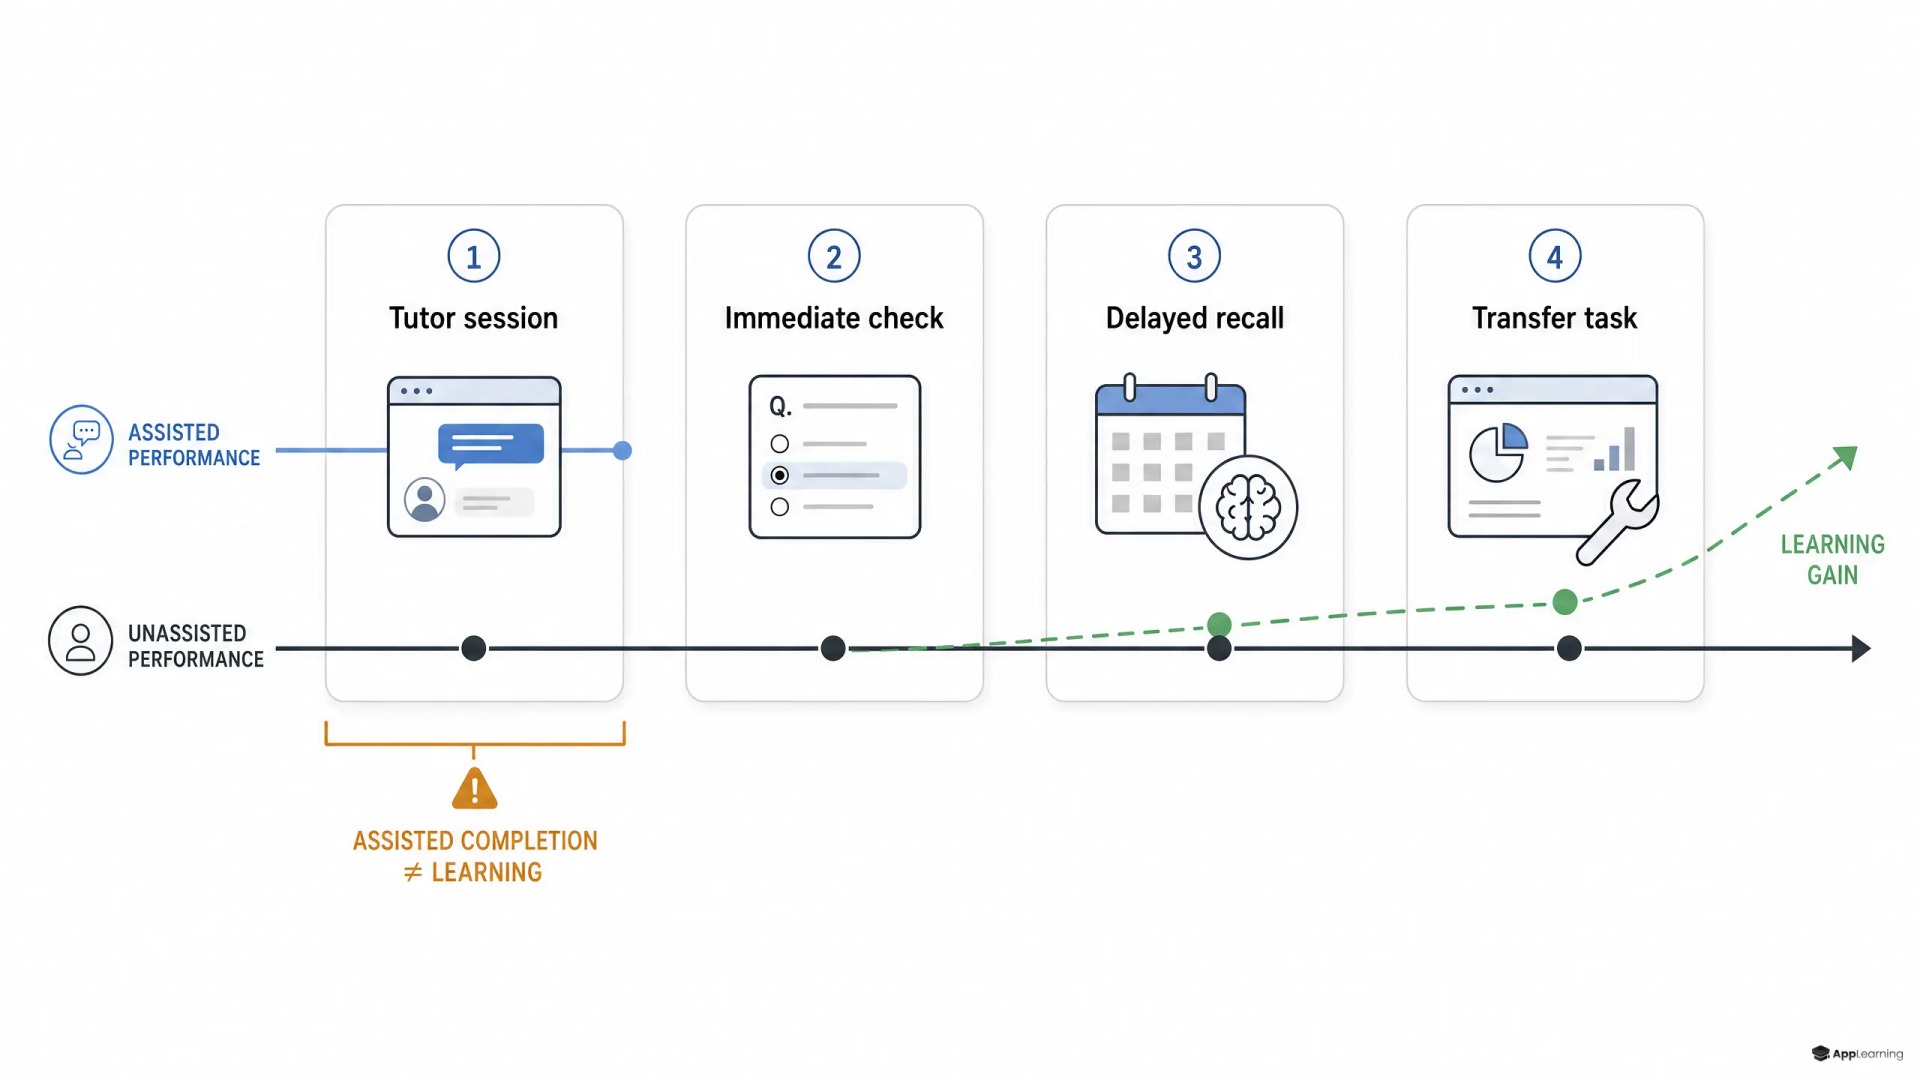
Die Qualität des Gesprächs ist wichtig, weil sie beeinflusst, ob Menschen sich darauf einlassen. Eine Tutor-Session ist aber eine Intervention, nicht das Ergebnis. Abschlussquoten, positive Bewertungen, übernommene Antworten und die Zeit im Chat zeigen, ob das System genutzt wird. Sie zeigen nicht, ob Lernende die Aufgabe jetzt allein bewältigen können.
Das ist der zentrale Messfehler bei KI-Tutoring in Unternehmen. Wenn Unterstützung und Bewertung im selben Ablauf stattfinden, kann der Tutor dabei helfen, die Belege zu erzeugen, anhand derer er selbst bewertet wird. Das führt zu überhöhten Leistungswerten – besonders wenn Lernende nach einer Antwort fragen können, statt Wissen abzurufen, abzuwägen und zu entscheiden.
Lernzuwachs wird zum aussagekräftigeren Signal
Die StudentBench-Forschung bringt das Feld mit einem belastbareren Studiendesign voran. Sie maß GRE-Lernzuwächse unter Bedingungen mit KI-Tutor, menschlichem Tutor und ohne Tutoring, statt nur Erklärungen zu bewerten. Die Ergebnisse sind vielversprechend, doch die Abgrenzung ist wichtig: Es handelt sich um einen aktuellen Preprint zur GRE-Vorbereitung von Studierenden, nicht um einen direkten Beleg dafür, dass KI-Tutoring im Unternehmen die Arbeitsleistung verbessert.
Der AI and Human Skill Atlas verweist auf dasselbe Bewertungsprinzip, indem er Studien zusammenführt, die Lernen ohne KI messen. Kontrollierte Forschung zum logischen Denken zeigt ebenfalls, dass eine intensivere KI-Nutzung mit einer schwächeren Kompetenzentwicklung verbunden sein kann. Gleichzeitig prägen die Qualität der Unterstützung und das Nutzungsverhalten der Lernenden das Ergebnis. Die Lehre daraus ist nicht, dass KI-Unterstützung grundsätzlich schadet. Leistung mit Unterstützung kann jedoch nicht als Beleg für Lernerfolge durch KI gelten.
Bewertung braucht eine klare Trennung
Trenne Lernunterstützung und Bewertung von Anfang an. Während der Tutor-Session sind Erklärungen, Übungen, Hinweise und Feedback sinnvoll. Beim Prüfpunkt wird der Assistent entfernt und es kommen neue Aufgaben zum Einsatz, die dasselbe Lernziel prüfen. Sobald die Bewertung beginnt, darf der Tutor weder die finale Antwort liefern noch die Frage umformulieren oder einen Hinweis geben.
Diese Trennung macht die Bewertung aussagekräftig und schafft Vertrauen bei Risiko-, Compliance- und Geschäftsverantwortlichen. Du kannst damit zeigen, dass Lernende die Schulung abgeschlossen, bei Bedarf Hilfe erhalten und anschließend ein festgelegtes Maß an eigenständigem Urteilsvermögen nachgewiesen haben.
Wissenserhalt und Transfer machen Abhängigkeit sichtbar
Eine sinnvolle Bewertung von KI-Tutoren umfasst drei Schritte. Direkt nach der Sitzung erfasst ein kurzer Test ohne Unterstützung den ersten Lernzuwachs. Nach einer festgelegten Zeitspanne, häufig nach sieben bis 14 Tagen, prüft ein kleiner, gleichwertiger Test, wie viel davon erhalten bleibt. Anschließend zeigt eine arbeitsnahe Szenarioaufgabe, ob Lernende das Wissen anwenden können: etwa indem sie aus einem unvollständigen Fall die nächste Kontrollmaßnahme ableiten und begründen.
Für betriebliches Lernen ist die Transferaufgabe entscheidend. Wer eine Compliance-Definition kennt, kann trotzdem scheitern, wenn Kundendruck, unklare Belege und Zeitdruck zusammenkommen. Richte die Szenarien deshalb an den Entscheidungen der jeweiligen Rolle aus. Der Wortlaut des Tutor-Gesprächs sollte nicht genügen, um sie zu lösen.
Good to know
Bedeutet ein Abschlusstest ohne Unterstützung, dass KI beim Lernen verboten werden sollte?
Nein. Nutze KI beim Üben und Coaching. Entferne sie nur, wenn du valide messen musst, was Lernende eigenständig können.
Wann sollte das Wissen erneut geprüft werden?
Wähle eine Zeitspanne, die zum Arbeitskontext und zur erwarteten Nutzung der Kompetenz passt. Eine Überprüfung nach sieben bis 14 Tagen ist für viele Akademie-Piloten ein praktikabler Ausgangspunkt. Passe sie anschließend an Risiko und Kompetenzverlust an.
Was macht eine Transferaufgabe glaubwürdig?
Sie sollte dasselbe Urteilsvermögen, dieselben Einschränkungen und Beweismuster verlangen wie die Rolle. Nutze neue Szenarien, damit Lernende nicht bestehen, indem sie sich an die Tutor-Session oder eine auswendig gelernte Antwort erinnern.
Beim Variantenvergleich auch die genutzte Unterstützung erfassen
Vergleiche Tutor-Modelle anhand mehrerer Kriterien. Halte Lernziel, Aufgabenschwierigkeit und Zusammensetzung der Lerngruppen möglichst konstant. Teile geeignete Lernende zufällig den Tutor- oder Modellvarianten zu und behalte, wo möglich, eine Kontrollgruppe ohne Tutor bei. Vergleiche anschließend den eigenständigen Lernzuwachs der Gruppen.
Erfasse für jede lernende Person den Unterstützungsstatus: ob KI verfügbar war, ob sie geöffnet wurde, wie viele Anfragen gestellt wurden, welche Hinweisstufe genutzt wurde und ob generierte Inhalte übernommen wurden. Eine App-Learning-Plattform kann diese Ereignisse jeder Tutor-Session, jedem Prüfpunkt ohne Unterstützung und jeder Szenarioaufgabe zuordnen. So wird Abhängigkeit sichtbar, statt in Chat-Protokollen verborgen zu bleiben.
Validität vor Wirtschaftlichkeit
Kosten, Antwortzeiten, Durchsatz und Lernaktivität bleiben wichtige Kennzahlen. Bewerte sie aber erst dann als Effizienzmerkmale, wenn der Tutor nachweislich Lernerfolge erzielt. Ein günstiges Modell, mit dem Aufgaben nur dank laufender Hilfe gelingen, spart auf Dauer wenig: Die Kosten fallen später bei Kontrollen, Fehlern und wiederholten Schulungen an.
Prüfe in deinem KI-Tutor-Piloten, was Lernende anschließend eigenständig können.
Pilot bewertenEine Scorecard für eigenständige Leistung
- Eigenständiger Lernzuwachs aus abgestimmten Vor- und Nachtests ohne Unterstützung
- Wissenserhalt bei einer späteren Prüfung gleichwertiger Lernziele
- Transferleistung in realistischen, rollenbasierten Szenarien
- Daten zum Unterstützungsstatus einschließlich Anfragen, Hinweisen und Antwortübernahmen
- Kosten pro Lernendem mit dauerhaftem Wissen – neben Latenz, Engagement und Abschluss
Mit einer solchen Übersicht wird KI-Tutoring zu einem überprüfbaren Beitrag zum Kompetenzaufbau. L&D-Teams können Prompts, Modelle und Lernabläufe verbessern und dabei klar zwischen Unterstützung und eigenständigem Können unterscheiden. Was der Tutor vermittelt hat, zeigt sich besonders dann, wenn das Gespräch endet und Lernende allein handeln müssen.